nanovllm相关
模型架构与 FlashAttention 底层优化解析
以下是对推理引擎中模型架构与注意力机制核心算子的技术推演与重构,侧重于计算瓶颈的分析、数学逻辑的推导以及硬件层面的 Trade-off。
1. 模型架构配置分析
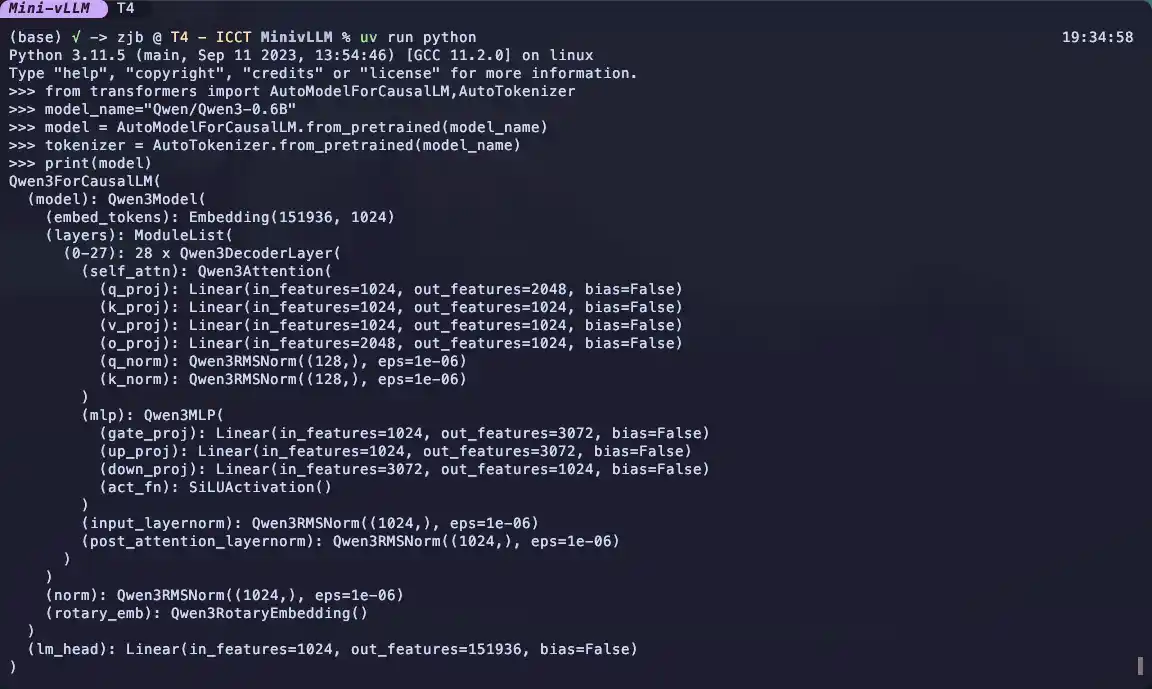
根据提取的维度信息(16 个 Q Head,8 个 KV Head,Head Dim = 128),该模型采用了 GQA (Grouped Query Attention) 架构,Q 与 KV 的比例为 2:1。
-
基础设施影响:相较于传统的 MHA (Multi-Head Attention),GQA 是推理阶段(尤其是 Decode 阶段)缓解 Memory Bound 的关键设计。KV Cache 的显存占用直接减少了 50%,极大降低了显存带宽的读写压力,并允许系统维持更大的 Batch Size 从而提升系统吞吐。
-
归一化选择:采用 RMSNorm 替代 LayerNorm,移除了均值计算(Mean-centering),在保证模型收敛和精度的前提下,减少了规约操作(Reduction)的开销,提升了前向推理的速度。
2. 标准 Attention 的硬件瓶颈 (Memory Wall)
传统 Attention 的计算流程受制于 GPU 的内存层级架构(HBM 与 SRAM 的速度差)。核心问题在于 IO Bound,而非 Compute Bound。
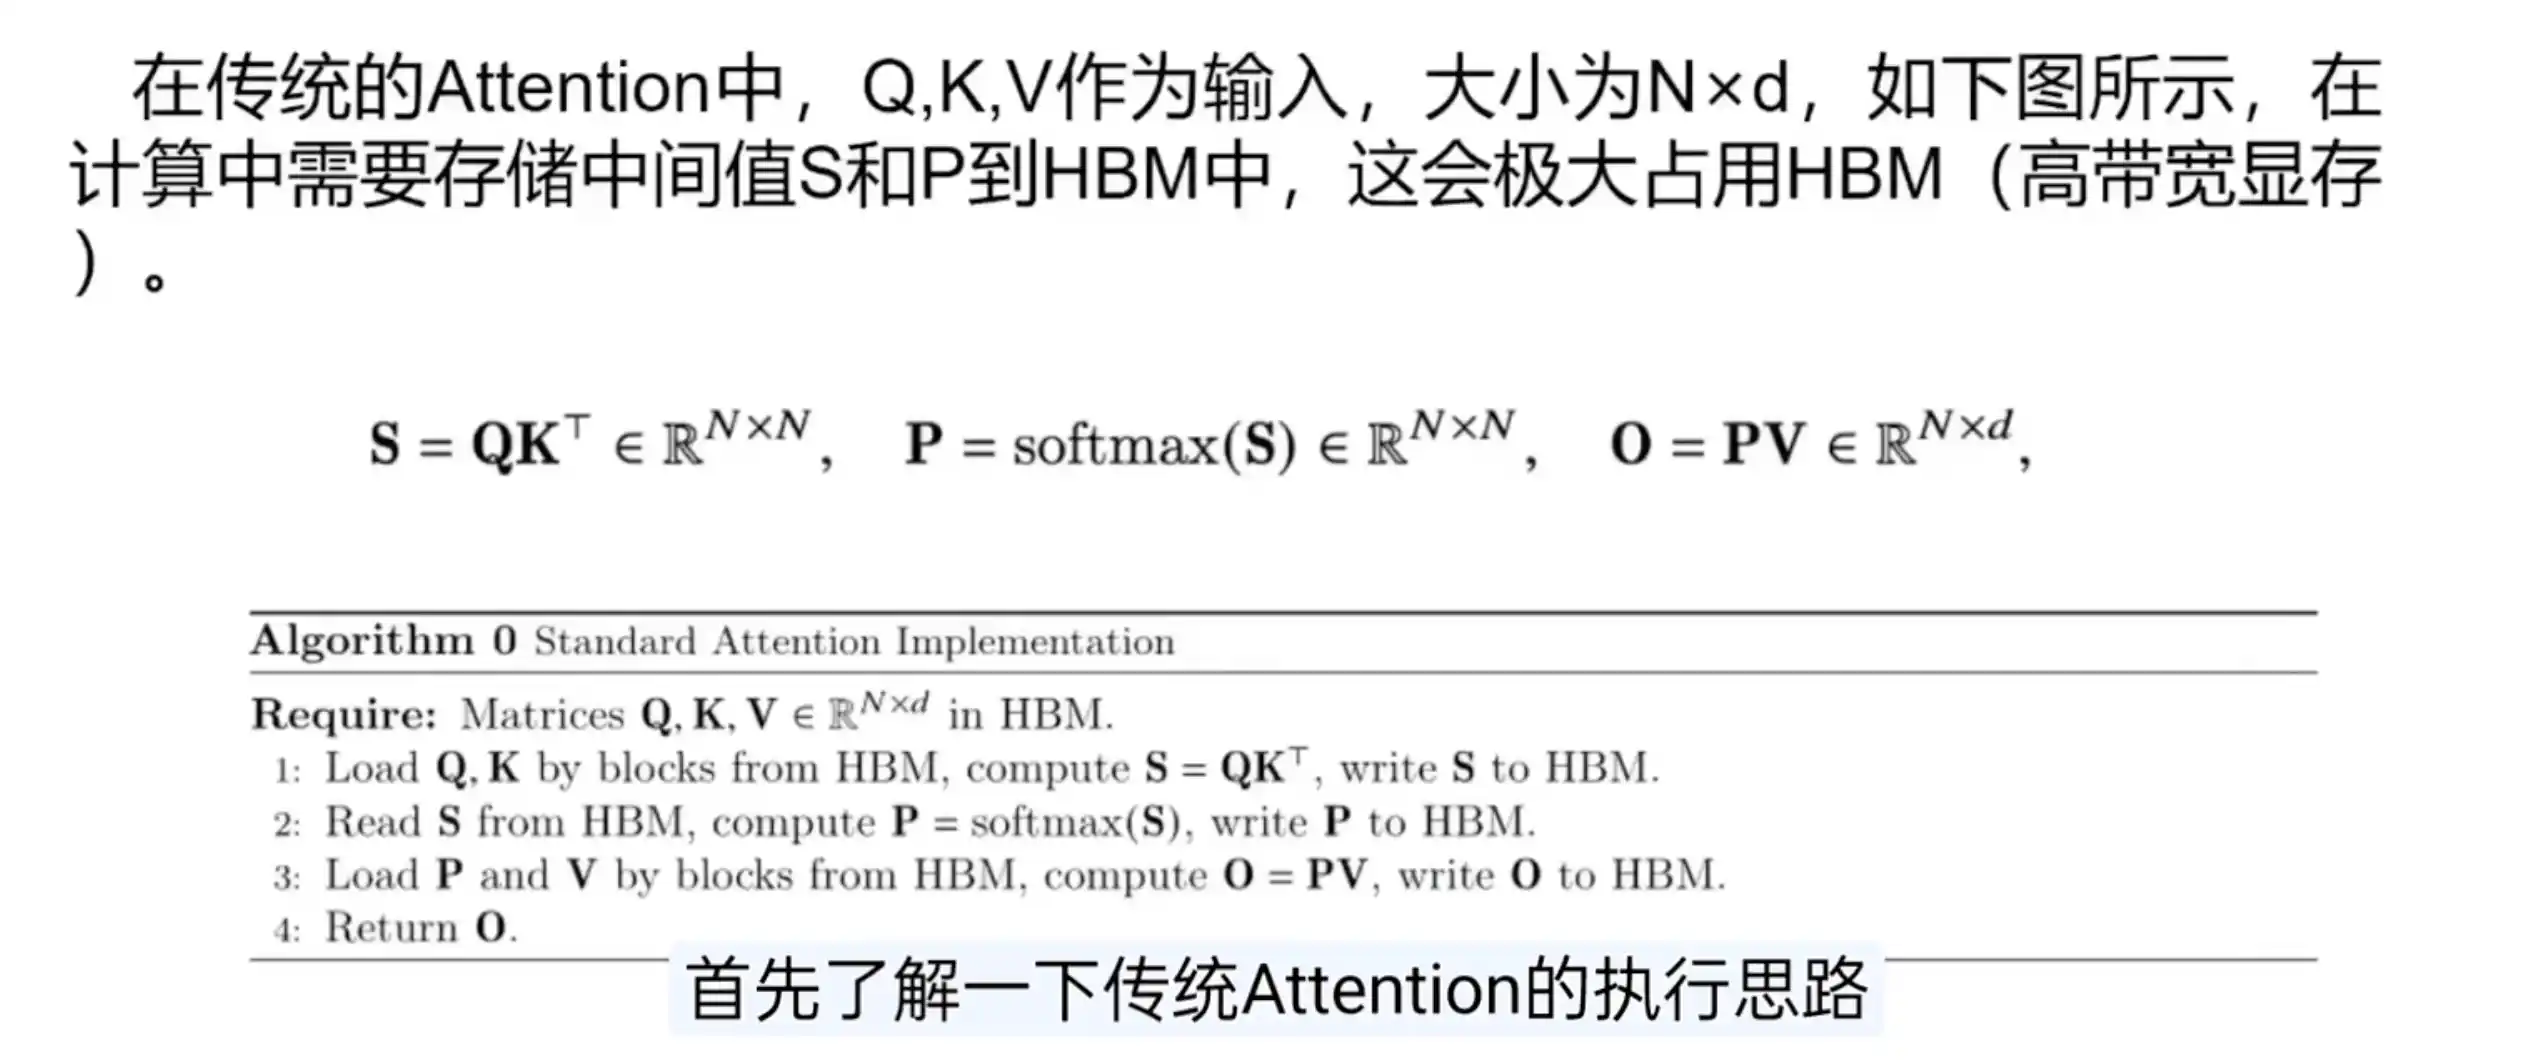
对于序列长度为
- 读 Q, K:从 HBM 读取所需数据,计算注意力分数矩阵
。 - 写 S:将
的 矩阵写入 HBM。 - 读 S, 写 P:读取
,计算 ,写回 HBM。 - 读 P, 读 V:读取
和 ,计算输出 。 - 写 O:将
的 写回 HBM。
其访存复杂度(IO Complexity)为
3. FlashAttention 核心解法之一:Online Softmax
为了消除
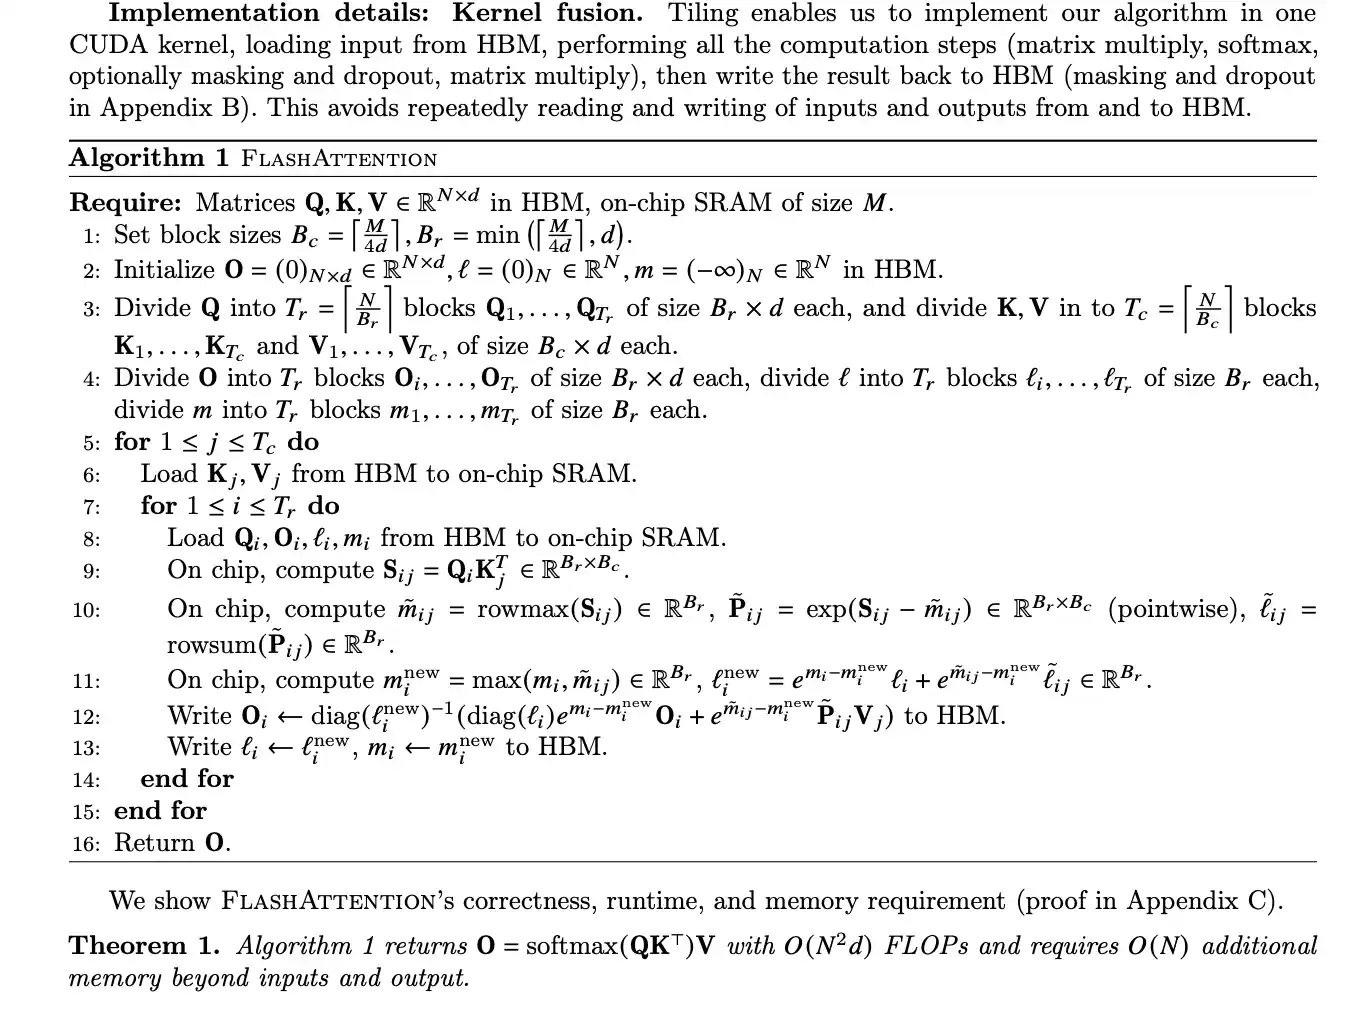
Online Softmax 的核心思想是:维护局部最大值和局部指数和,当引入新块时,通过缩放(Rescaling)修正历史结果。
假设我们将输入分成多个块。对于第
- 局部最大值:
- 局部指数和:
- 未归一化的输出值:
当第
- 更新全局最大值:
- 修正历史指数和并更新总和:
原有的和是基于旧的最大值 计算的,需要乘上衰减因子 进行修正。
- 修正历史输出并累加新块:
原有的未归一化输出同样需要用衰减因子修正,再加上新块的贡献。
$$\tilde{O}{new} = \tilde{O}^{(k)} \cdot e^{m^{(k)} - m{new}} + \tilde{O}^{(k+1)} \cdot e^{m^{(k+1)} - m_{new}}$$
在所有分块遍历完成后,只需要执行一次最终的除法 $\tilde{O}{final} / l{final}
4. FlashAttention 核心解法之二:Tiling 与硬件映射
有了 Online Softmax 的数学基础,就可以将计算逻辑映射到硬件上,最大化利用 SRAM。
-
内存分配:SRAM 的空间有限。需要根据 SRAM 大小设定分块参数
(行块大小,对应 Q)和 (列块大小,对应 K 和 V)。在 SRAM 中只需分配能够容纳下 以及 的空间。对于 FP16,占用大致为 。 -
双层循环调度:
- 外层循环:遍历 KV 的块。将
和 从 HBM 加载到 SRAM。 - 内层循环:遍历 Q 的块。将
加载到 SRAM,与 计算局部 。 - 立即在 SRAM 中执行 Online Softmax 更新,随后乘上
更新 。 - (但是 innerloop 每次结束 都要写 Oml 下次还要返回,所以v2 在Q tiling 并行,遍历KV 不用反复读写Olm,更快切减小溢出风险。)
- 外层循环:遍历 KV 的块。将
5. 思考
用计算换 IO (Compute for Memory)
FlashAttention 实际上增加了总的浮点运算次数(FLOPs)。因为在 Online Softmax 中引入了大量的
 微信
 支付宝